最新AI教程资讯

InternVL3 – 上海 AI Lab 开源的多模态大语言模型
InternVL3是上海人工智能实验室开源的多模态大型语言模型(MLLM),具有卓越的多模态感知和推理能力。模型系列包括1B到78B共7个不同尺寸的版本,能同时处理文字、图片、视频等多种信息。
2025-05-11 19:33:52

豆包1.5·UI-TARS – 字节豆包推出的 GUI Agent 模型
豆包1 5·UI-TARS是字节豆包推出的面向图形界面交互(GUI)的Agent模型。模型基于感知、推理和动作执行等类人能力,与图形界面进行连续、流畅的交互。模型将视觉理解、逻辑推理、界面元素定位和操作整合在单一模型中,无需预定义工作流程或人工规则,实现端到端的任务自动化。
2025-05-11 18:33:52

GoodWeBot – 基于 RPA 技术开源的 AI 微信机器人
GoodWeBot 是开源的基于 RPA 技术开发的 AI 微信机器人, 支持一键免安装运行,用户下载后即可直接使用。工具已接入 Coze 等主流 AI,能实现智能回复、私聊群发、群聊群发、自动加好友、接受好友申请以及自动给好友打标签等功能。
2025-05-11 17:33:52

万相首尾帧模型 – 阿里通义开源的首尾帧生视频模型
万相首尾帧模型(Wan2 1-FLF2V-14B)是开源的14B参数规模的首尾帧生视频模型。模型根据用户提供的首帧和尾帧图像,自动生成流畅的高清视频过渡效果,支持多种风格和特效变换。
2025-05-11 16:33:52

InstantCharacter – 腾讯混元开源的定制化图像生成插件
InstantCharacter 是腾讯混元开源的定制化图像生成插件。基于扩散 Transformer(DiT)框架,引入可扩展的适配器(包含多个 Transformer encoder)和千万级样本的大规模角色数据集,实现高保真、文本可控且角色一致的图像生成。
2025-05-11 15:33:53

MAI-DS-R1 – 微软开源的 AI 模型,基于 DeepSeek R1 改进版
MAI-DS-R1 是微软基于 DeepSeek R1 改进的AI模型。MAI-DS-R1基于后训练优化,支持响应 99 3% 的敏感话题提示,比原版提升 2 倍,将有害内容风险降低 50%。MAI-DS-R1 在推理能力上保持与 DeepSeek R1 相同的水平,支持多语言回答,适用于国际组织、跨国企业和教育机构等多语言环境。
2025-05-11 14:33:52

FramePack – 斯坦福开源的视频生成技术
FramePack 是斯坦福大学推出用在视频生成的技术。基于压缩输入帧的上下文长度,解决视频生成中的“遗忘”和“漂移”问题,让模型能高效处理大量帧,保持较低的计算复杂度。FramePack 仅需 6GB 显存在普通笔记本电脑上运行,支持实时生成高清视频,基于抗漂移采样技术保证视频的稳定性和连贯性。
2025-05-11 13:33:52

Animate Anyone – 阿里推出的图像到视频角色动画合成的框架
Animate Anyone是由阿里巴巴智能计算研究院推出的一款将静态图像中的角色或人物进行动态化的开源框架,该框架在扩散模型的基础之上,引入了ReferenceNet、Pose Guider姿态引导器和时序生成模块等技术,以实现照片动起来时保持一致性、可控性和稳定性,输出高质量的动态化视频。
2025-05-11 12:33:52

ReplaceAnything – 阿里推出的AI替换图片中物体的开源框架
ReplaceAnything是由阿里巴巴智能计算研究院推出的一款开源AI图像内容替换框架,利用先进的人工智能技术,能够实现对照片或图像中物体的智能替换。用户可以通过简单的操作,只需框选想要保留的图像部分,输入提示词或描述来替换想要更改的图像区域,如更换人物发型、服装、背景等。
2025-05-11 11:33:52

Outfit Anyone – 阿里开源的一键换衣虚拟试穿项目
Outfit Anyone是由阿里巴巴智能计算研究院推出的一个高质量服装虚拟试穿的开源项目,借助该技术,用户或模特无需亲自试穿衣服即可预览上身效果。Outfit Anyone采用双流条件扩散模型,处理模特、服装和文本提示,通过衣物图像作为控制因素实现更逼真的虚拟试穿效果。
2025-05-11 10:33:52

FaceChain – 阿里推出的人物写真和个人形象生成框架
FaceChain是阿里巴巴达摩院推出的一个开源的人物写真和个人数字形象的AI生成框架(类似于免费开源版的妙鸭相机),用户仅需要提供最少一张照片即可生成独属于自己的个人形象数字替身。该AI框架利用了Stable Diffusion模型的文生图功能并结合人像风格化LoRA模型训练及人脸相关感知理解模型,将输入的图片进行训练后推理输出生成为个人写真图像。
2025-05-10 17:31:38

I2VGen-XL:阿里推出的图像到视频生成模型
I2VGen-XL 是阿里巴巴达摩院推出的一款开源的图像到视频的生成模型,通过创新的级联扩散方法,将文本视频数据与视频结构解耦,同时利用静态图像作为关键指导形式,确保了输入数据的对齐性,将静态图像合成为高质量的动态视频。
2025-05-10 16:31:38

MagicVideo-V2:字节跳动推出的AI视频生成模型
MagicVideo-V2 是字节跳动公司团队开发的一款AI视频生成模型,通过将文本到图像模型、视频运动生成器、参考图像嵌入模块和帧插值模块集成到一个端到端的视频生成流程中,可以生成高保真和美观的视频,并实现高分辨率视觉质量与流畅运动的一致性。
2025-05-10 15:31:38

Motionshop – 阿里推出的AI角色动画项目,可替换视频人物为3D
Motionshop是阿里巴巴智能计算研究院推出的一个AI角色动画框架,可将视频中的人物角色替换为3D化身,同时不改变视频中的其他场景和人物。该框架利用视频处理、角色检测 分割 追踪、姿态分析、模型提取和动画渲染等多种技术,使得动态视频中的主角能够轻松跨越现实与虚拟的界限,一键变身为有趣的3D角色模型。
2025-05-10 14:31:38

AnyText – 阿里开源的视觉图像文字生成和编辑模型
AnyText是阿里巴巴智能计算研究院的团队推出的一个基于扩散的多语言视觉文本生成和编辑模型,专注于在图像中渲染准确和连贯的文本。AnyText包括两个主要元素的扩散管线:辅助潜在模块和文本嵌入模块。
2025-05-10 13:31:38

InstantID – 高保真的个性化图像合成框架
InstantID是一种基于扩散模型的图像生成技术,它专注于实现零次(zero-shot)身份保留(Identity-Preserving)的个性化图像合成。这项技术允许用户仅使用一张面部图像,就能在多种风格中生成个性化的图像,同时确保高保真度,类似于PhotoMaker的生成效果。
2025-05-10 12:31:39

VideoCrafter2 – 腾讯推出的高质量视频生成模型
VideoCrafter2是一个由腾讯AI实验室开发的视频生成模型,旨在克服高质量视频数据获取的局限性,训练出能够生成高质量视频的模型。该模型的核心思想是将视频的生成过程分解为两个主要部分:运动(motion)和外观(appearance)。
2025-05-10 11:31:38
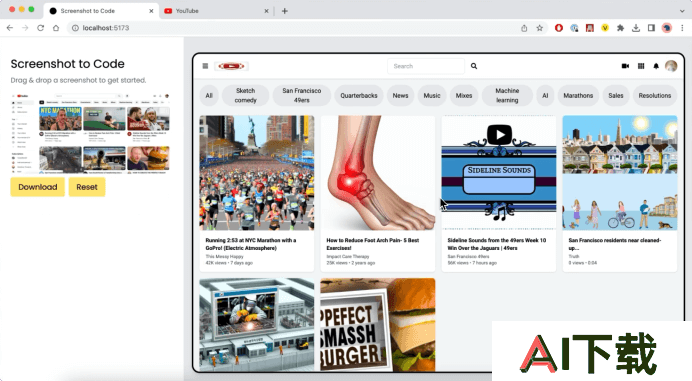
Screenshot to Code – AI将截图转换为网页代码的开源项目
Sscreenshot to Code是一个开源的项目,利用人工智能技术(GPT-4V 和 DALL·E 3)将用户的屏幕截图转换为前端网页代码。项目的核心功能是自动化网页设计的编码过程,使得开发者能够通过提供网页的截图,快速生成相应的HTML、CSS和JavaScript代码,节省前端开发人员的时间和精力。
2025-05-10 10:31:38

DDColor – 阿里推出的AI图像上色框架,将黑白图片变彩色
DDColor是阿里达摩院的研究人员推出的一个开源的AI图像着色框架,可以一键将黑白图片上色变为全彩图像。该方法通过使用双解码器架构(像素解码器和颜色解码器)来实现对灰度图像的自动着色,使得生成的彩色图像更加逼真和生动。
2025-05-10 09:31:38

Real-ESRGAN:腾讯推出的开源图像分辨率提升模型
Real-ESRGAN(Real-World Blind Super-Resolution with Pure Synthetic Data)是由腾讯的研究团队推出的一个深度学习模型,专门用于处理和提升低分辨率图像到高分辨率图像的质量。这个模型的特点是能够在没有真实高分辨率图像作为参考的情况下,通过合成的退化过程来训练,从而模拟现实世界中的图像退化。这种方法被称为“盲超分辨率”(blind super-resolution),因为它不需要知道图像是如何从高分辨率退化到低分辨率的。
2025-05-09 16:10:17
人气排行
24小时排行


