最新AI教程资讯

Transformer Debugger – OpenAI开源的理解和分析大模型内部的工具
Transformer Debugger (TDB) 是由 OpenAI 的对齐团队(Superalignment)开发的一款工具,旨在帮助研究人员和开发者更深入地理解和分析 Transformer 模型的内部结构和行为。
2025-02-27 17:55:39

Pix2Gif – 微软推出的静态图像转动态GIF的扩散模型
Pix2Gif是由微软研究院的研究人员提出的一个基于运动引导的扩散模型,专门用于将静态图像转换成动态的GIF动画 视频。该模型通过运动引导的扩散过程来实现图像到GIF的生成,利用文本描述和运动幅度提示作为输入,来引导图像内容的动态变化。
2025-02-27 17:26:26

ComflowySpace – 免费开源且简单易用的ComfyUI整合工具
ComflowySpace是一款专为简化和增强AI图像及视频生成工具使用体验而设计的开源软件,基于ComfyUI和Stable Diffusion,旨在提供一个更加用户友好和高效的工作台界面。相比SD WebUI和ComfyUI的复杂设置,ComflowySpace提供更加易上手和更具互动性的体验。
2025-02-27 17:05:45

Follow-Your-Click – 腾讯等开源的图像到视频模型,可生成局部动画
Follow-Your-Click是一个由来自腾讯公司(混元团队)联合清华大学和香港科技大学的研究人员共同研发的图像到视频(Image-to-Video,简称I2V)生成模型,允许用户通过简单的点击和简短的动作提示来生成局部图像动画,从而将静态图像转换为动态视频。
2025-02-27 16:36:36

AutoDev – 微软推出的AI编程和程序开发智能体框架
AutoDev是由微软的研究人员推出的一个AI编程和程序开发智能体框架,专门设计用于自主规划和执行复杂的软件工程任务,如代码编写、调试、测试和版本控制等。AutoDev的目标是提高软件开发的效率和质量,同时减少开发人员在某些重复性或繁琐任务上的负担。
2025-02-27 16:09:19

Grok-1 – 马斯克旗下xAI开源的大模型,参数量3140亿
Grok-1 是由马斯克旗下的人工智能初创公司 xAI 开发的一款大型语言模型,是一个混合专家(MoE)模型,拥有 3140 亿参数,使其成为目前参数量最大的开源大语言模型。Grok-1 的开发和训练过程遵循了开源的原则,其权重和网络架构已经公开,基于Apache 2 0许可,允许用户自由地使用、修改和分发,用于个人和商业用途。
2025-02-27 15:42:21

Open-Sora – 开源的类Sora架构的视频生成模型和复现方案
Open-Sora是由Colossal-AI团队开源的视频生成模型,旨在复现OpenAI的Sora视频生成产品。Open-Sora同样基于DiT架构,通过三个阶段训练:大规模图像预训练、大规模视频预训练和高质量视频数据微调,以生成与文本描述相符的视频内容。
2025-02-27 15:16:11

VLOGGER – 谷歌推出的图像到合成人物动态视频的模型
VLOGGER AI是谷歌的研究团队开发的一个多模态扩散模型,专门用于从单一输入图像和音频样本生成逼真的、连贯的人像动态视频。该模型的主要功能在于使用人工智能模型,将一张静态图片转换成一个动态的视频角色,同时保持照片中人物的逼真外观。
2025-02-27 14:29:33

Stable Video 3D (SV3D) – 多视角合成和3D生成模型,由Stability AI推出
Stable Video 3D(简称SV3D)是由Stability AI公司开发的一项先进的3D技术,能够从单张图片生成高质量的新视角视图和3D网格。该模型在之前发布的Stable Video Diffusion模型的基础上进行了改进,提供了更好的质量和多视角体验。
2025-02-27 14:03:18

AnimateDiff-Lightning – 字节推出的快速生成高质量视频的模型
AnimateDiff-Lightning由字节跳动的研究人员最新推出的一个高质量视频生成模型,利用了渐进式对抗性扩散蒸馏技术来实现快速的视频生成。该模型旨在解决现有视频生成模型在速度和计算成本上的主要挑战,同时保持生成视频的高质量,相较于原始的 AnimateDiff,生成视频的速度快十倍以上!
2025-02-27 13:39:38

StreamMultiDiffusion – 实时生成和编辑图像的交互式框架
StreamMultiDiffusion是一个实时交互式的图像生成框架,结合了扩散模型的高质量图像合成能力和区域控制的灵活性,可根据用户指定的区域文本提示生成实时、交互式、多文本到图像。该框架的目的是提高图像生成的速度和用户交互性,使得用户能够实时地生成和编辑图像。
2025-02-27 13:10:51

Mora – 微软等推出的可生成12秒视频的多AI智能体框架
Mora是由来自微软和理海大学的研究人员推出的一个多智能体(AI Agents)框架,专门用于通用视频生成任务,目标是模拟并扩展OpenAI的Sora视频生成模型。该框架的核心理念是通过多个视觉智能体的协作来生成高质量的视频内容,Mora通过分解视频生成过程为多个子任务,并为每个子任务分配一个专门的智能体,从而实现了各种视频生成的功能。
2025-02-27 12:50:20

LATTE3D – 英伟达推出的文本快速生成3D对象的模型
LATTE3D是由英伟达的研究人员推出的一个文本生成3D对象的模型,能够从文本提示描述快速生成高质量的3D内容(仅需400毫秒)。该技术的核心在于采用了一种称为“摊销优化(amortized)”的方法,即在大量文本提示上同时优化一个共享的文本条件模型,以此提高模型对新提示的泛化能力,从而减少了生成每个3D对象所需的时间。
2025-02-27 12:27:18

BrushNet – 腾讯推出的高质量图像照片修复模型
BrushNet是由腾讯PCG部门的ARC实验室与香港大学的研究人员推出的一个基于扩散模型的即插即用的图像照片修复(Inpainting)模型,通过分解的双分支架构来有效处理图像中的遮罩区域,可保持原有图像内容连贯性的同时,生成高质量的修复结果。
2025-02-27 12:05:42
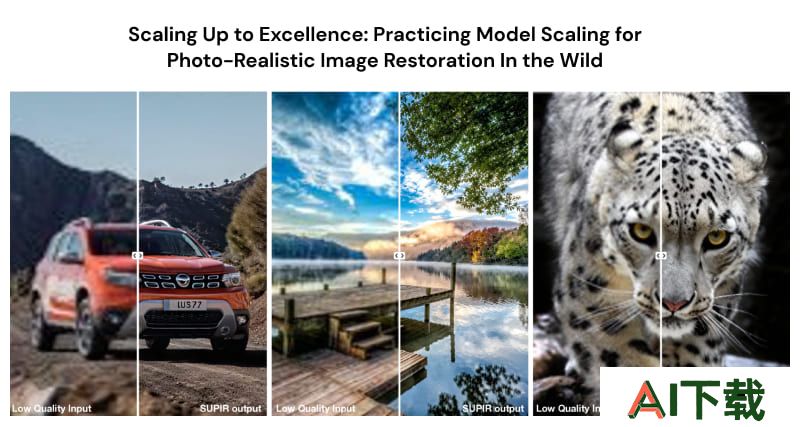
SUPIR – 高保真的AI图像修复和画质增强模型
SUPIR是一个突破性的图像修复和画质增强方法,利用了大规模的生成模型StableDiffusion-XL(SDXL)和模型扩展技术,通过深度学习和多模态方法,实现了对低质量图像的高质量恢复。
2025-02-27 11:44:06

StreamingT2V – PicsArt推出的可生成长达2分钟视频的模型
StreamingT2V是由PicsArt AI研究团队推出的一个文本到视频的生成模型,旨在解决现有模型仅能生成16帧或24帧的高质量短视频,在生成长视频时则会遇到如视频质量下降、场景转换不一致和视频停滞等问题的挑战。
2025-02-27 11:16:29

VoiceCraft – 开源的语音编辑和文本转语音模型
VoiceCraft是一个由德克萨斯大学奥斯汀分校研究团队开源的神经编解码器语言模型,专注于零样本语音编辑和文本到语音(TTS)任务。该模型采用Transformer架构,通过创新的token重排过程,结合因果掩蔽和延迟叠加技术,可零样本实现在现有音频序列内的高效生成。
2025-02-27 10:54:20

Champ – 基于3D的人物图片转视频动画模型
Champ是由阿里巴巴、复旦大学和南京大学的研究人员共同提出的一种基于3D的将人物图片转换为视频动画的模型,该方法结合了3D参数化模型(特别是SMPL模型)和潜在扩散模型来生成高质量的人类动画视频,可通过精确捕捉人体的形状和姿势变化,从而创建出既可控又时间上连贯的动画效果。
2025-02-27 10:32:29

Jamba – AI21开源的首个基于Mamba架构的大模型
Jamba是由AI21 Labs推出的首个基于Mamba架构的生产级别的大语言模型,目前大部分的大模型(如GPT、Gemini 和 Llama)都是基于 Transformer 结构。而 Jamba 结合了 Mamba 结构化状态空间模型(SSM)和 传统Transformer 架构,兼具了高质量输出、高吞吐量和低内存占用的优点。
2025-02-27 10:10:07

Universal-1 – AssemblyAI推出的多语种语音识别和转换模型
Universal-1是AI语音初创公司AssemblyAI推出的一款多语言语音识别和转录模型,经过超过1250万小时的多语种音频数据训练,支持英语、西班牙语、法语和德语等。
2025-02-27 09:26:50
人气排行
24小时排行


